Tech
Z-Image Turbo in ComfyUI: derselbe Aufbau, ein Bruchteil der Steps
Nachdem ich im letzten Beitrag einen kompletten Text-zu-Bild-Workflow für Flux.1-Dev von Grund auf zusammengesteckt habe, will ich heute ein zweites Modell danebenstellen: Z-Image Turbo. Das ist ein neueres, konsequent auf Geschwindigkeit getrimmtes Diffusionsmodell, und der Reiz daran ist, dass der Workflow drumherum fast identisch aussieht - man kann also sein gewohntes Setup fast eins zu eins übernehmen. Fast. Genau um diese Unterschiede geht es mir hier.
Den grundsätzlichen Aufbau - was CLIP als Text-Encoder macht, warum es einen VAE braucht, was die einzelnen KSampler-Parameter bedeuten - habe ich im Flux-Beitrag ausführlich erklärt. Das wiederhole ich hier nicht alles noch einmal, sondern konzentriere mich auf das, was bei Z-Image Turbo anders läuft.
Was Z-Image Turbo anders macht
Bevor wir in den Workflow schauen, lohnt sich der Blick auf die drei entscheidenden Unterschiede zu Flux.1-Dev:
- Es ist ein Turbo-Modell. Das „Turbo" im Namen ist Programm: Das Modell ist so destilliert, dass es schon nach ganz wenigen Schritten ein fertiges Bild liefert. Wo ich bei Flux mit rund
20Steps gearbeitet habe, sind es hier nur noch8. Das macht die Generierung spürbar schneller - gerade zum Ausprobieren und für schnelle Iterationen ist das Gold wert. - Nur ein Text-Encoder statt zweier. Flux fährt zweigleisig mit einem kleinen CLIP und dem großen t5xxl. Z-Image Turbo kommt mit einem einzigen Encoder aus (
qwen_3_4b). Statt eines DualCLIPLoaders brauchen wir hier deshalb nur einen schlichten Load CLIP. - Ein echter Negative Prompt statt FluxGuidance. Bei Flux gab es den FluxGuidance-Node, und den Negative Prompt haben wir mit ConditioningZeroOut neutralisiert, weil Flux ihn ohnehin ignoriert. Bei Z-Image Turbo fällt der Guidance-Node komplett weg, dafür hängen zwei ganz normale CLIP Text Encode-Nodes am Sampler - einer für den positiven, einer für den negativen Prompt.
Unterm Strich: gleicher Grundriss, aber deutlich schlanker und schneller. Und damit auch weniger Speicherhunger, was auf meiner Karte mit 16GB natürlich willkommen ist.
Die Nodes im Detail
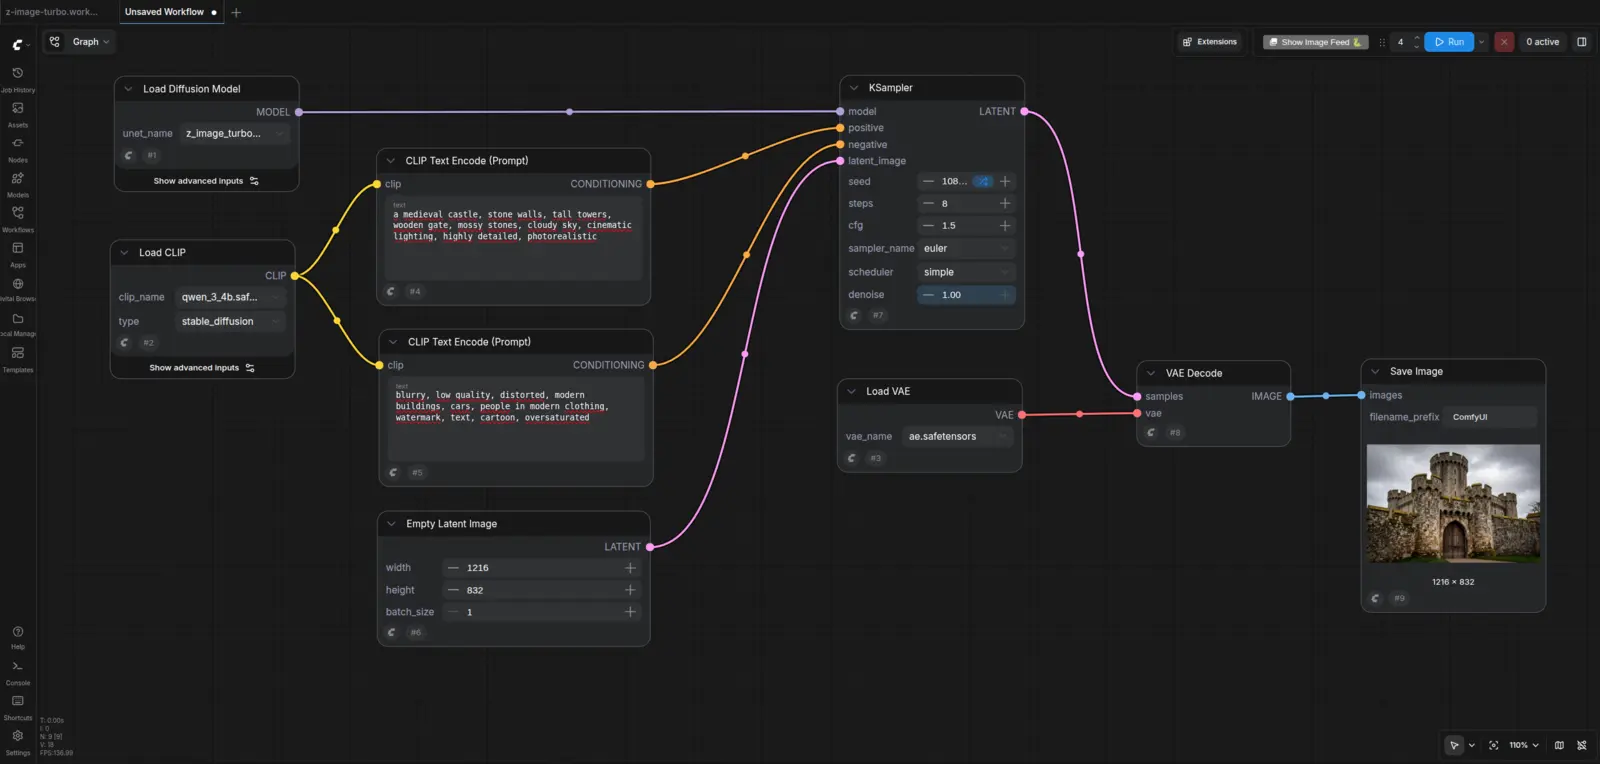
Wie man auf dem Screenshot sieht, ist das Grundgerüst dasselbe wie bei Flux. Ich gehe die Nodes deshalb nur kurz durch und halte mich bei den Abweichungen auf.
Load Diffusion Model
Wie gehabt der erste Node, um das Modell zu laden. Bei unet_name wählt man hier eben z_image_turbo statt flux1-dev aus - ansonsten ändert sich nichts.
Load CLIP
Das ist der erste echte Unterschied. Statt des DualCLIPLoaders aus dem Flux-Workflow nimmt man hier einen einfachen Load CLIP, weil Z-Image Turbo eben nur einen Text-Encoder verwendet. Bei clip_name wählt man qwen_3_4b.safetensors, den type stellt man auf stable_diffusion.
In meinem Beispiel oben habe ich mit einer klassischen, kommagetrennten Stichwort-Liste gearbeitet. Aus Neugier habe ich denselben Inhalt aber auch einmal als ausformulierten Satz beschrieben - und heraus kam ein genauso gutes Bild. Man ist bei Z-Image Turbo also nicht auf Stichwort-Listen angewiesen, sondern kann seinen Prompt genauso gut in ganzen Sätzen formulieren (ähnlich wie bei Flux). Was einem besser liegt, ist am Ende Geschmackssache.
Load VAE
Hier ändert sich nichts. Wie bei Flux kommt ein Load VAE mit ae.safetensors zum Einsatz - der Übersetzer, der die Latents am Ende wieder in ein sichtbares Pixelbild verwandelt.
CLIP Text Encode (Prompt) - diesmal zweimal
Statt eines einzelnen Prompt-Nodes plus FluxGuidance haben wir hier zwei CLIP Text Encode-Nodes: einen für den positiven und einen für den negativen Prompt. Den Ausgang des Load CLIP verbindet man mit beiden.
In meinem Beispiel steht im positiven Prompt schlicht, was ich sehen will:
a medieval castle, stone walls, tall towers, wooden gate,
mossy stones, cloudy sky, cinematic lighting, highly detailed, photorealistic
Und im negativen, was ich vermeiden will:
blurry, low quality, distorted, modern buildings, cars,
people in modern clothing, watermark, text, cartoon, oversaturated
Ein Detail muss man dabei allerdings kennen: Der negative Prompt wirkt nur, wenn der cfg-Wert über 1.0 liegt. Bei genau 1.0 überspringt ComfyUI den Negativ-Zweig komplett - der zweite Node wäre dann schlicht wirkungslos. Ich habe cfg deshalb im KSampler auf 1.5 gestellt (dazu unten mehr); damit greift der Negativ-Prompt und hält Dinge wie moderne Gebäude, Autos oder Wasserzeichen tatsächlich aus dem Bild heraus.
Empty Latent Image
Unverändert. Ich lasse es wie bei Flux auf 1216x832 bei einer batch_size von 1. Auch hier gilt die Faustregel, in der Nähe von einem Megapixel Gesamtfläche zu bleiben.
KSampler
Der Node ist derselbe wie bei Flux, aber zwei Werte machen den Turbo-Charakter aus:
- steps steht auf
8statt auf20. Genau das ist der Geschwindigkeitsgewinn - das destillierte Modell braucht schlicht nicht mehr Schritte, um ein sauberes Bild zu liefern. - cfg habe ich auf
1.5gestellt. Bei1.0wäre der negative Prompt wirkungslos (siehe oben), ein kleiner Schubs nach oben aktiviert ihn. Viel höher sollte man bei einem destillierten Turbo-Modell aber nicht gehen, sonst bricht das Bild auseinander -1.5bis maximal etwa3.0ist ein brauchbarer Korridor.
Der Rest ist Gewohnheit: sampler_name auf euler, scheduler auf simple, denoise auf 1.0. Wichtig zu sehen ist, dass hier beide Prompt-Nodes andocken - der positive an positive, der negative an negative. Einen ConditioningZeroOut wie bei Flux brauchen wir dafür nicht mehr.
VAE Decode und Save Image
Zum Schluss wie immer: Der VAE Decode verwandelt das Ergebnis des Samplers zusammen mit dem geladenen VAE in ein Pixelbild, und Save Image speichert es ab. Beides genau wie im Flux-Workflow.
Beim Prompt lieber Englisch
Eine Beobachtung will ich noch unbedingt loswerden: Bei Z-Image Turbo ist Englisch beim Prompt praktisch Pflicht. Ich habe den englischen Prompt von oben einmal wörtlich ins Deutsche übersetzt:
Positiv: eine mittelalterliche Burg, Steinmauern, hohe Türme, ein Holztor,
moosbewachsene Steine, bewölkter Himmel, filmreife Beleuchtung, sehr detailreich, fotorealistisch
Negativ: unscharf, schlechte Qualität, verzerrt, moderne Gebäude, Autos,
Menschen in moderner Kleidung, Wasserzeichen, Text, Cartoon, übersättigt
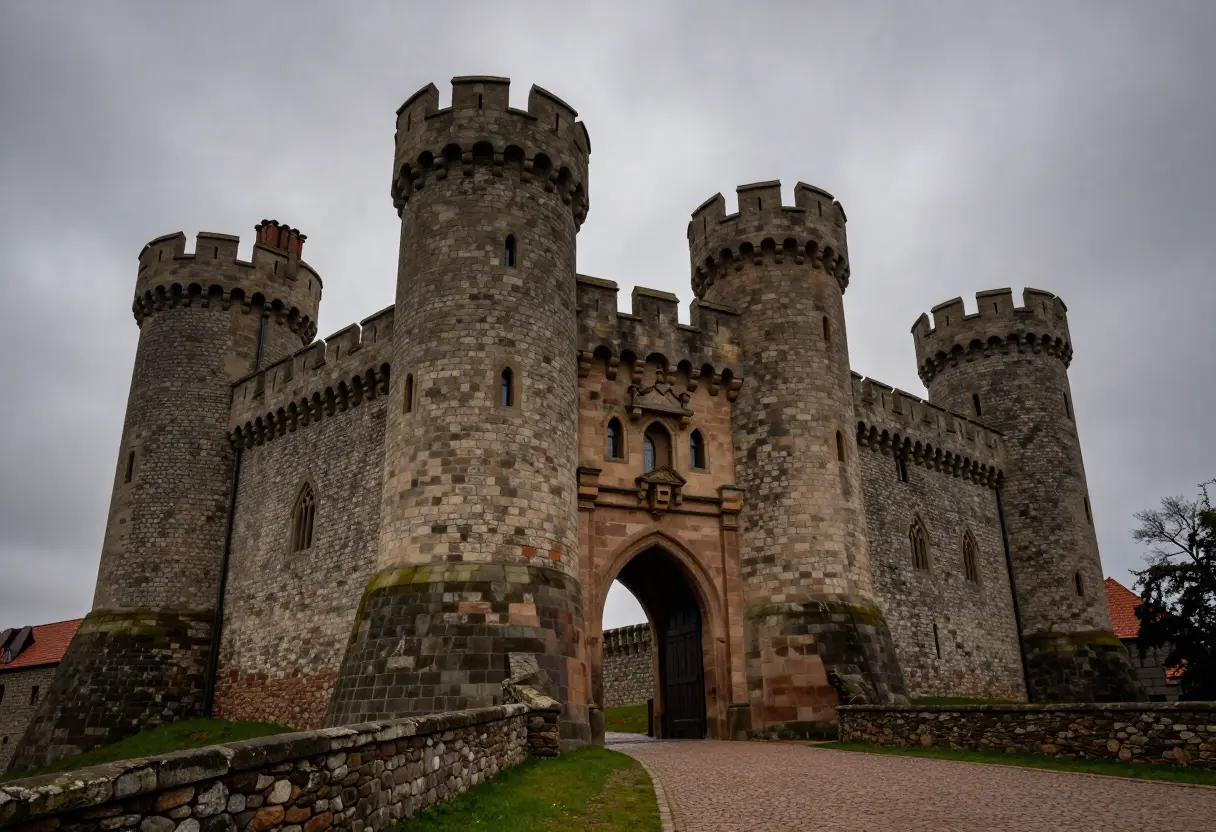
Mit dem englischen Prompt kamen durchweg saubere, stimmige Bilder heraus - man achte etwa darauf, wie schön das geforderte Moos („mossy stones") auf den Mauerkronen sitzt:
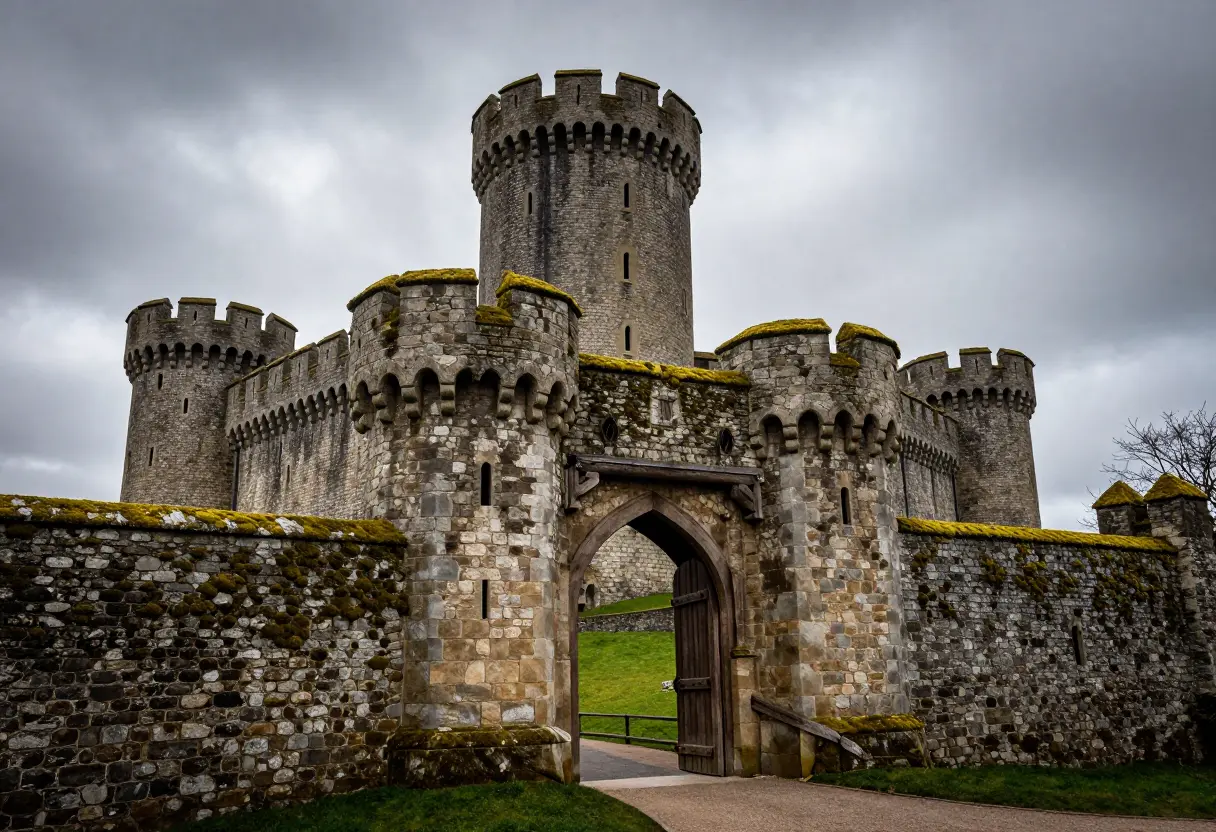
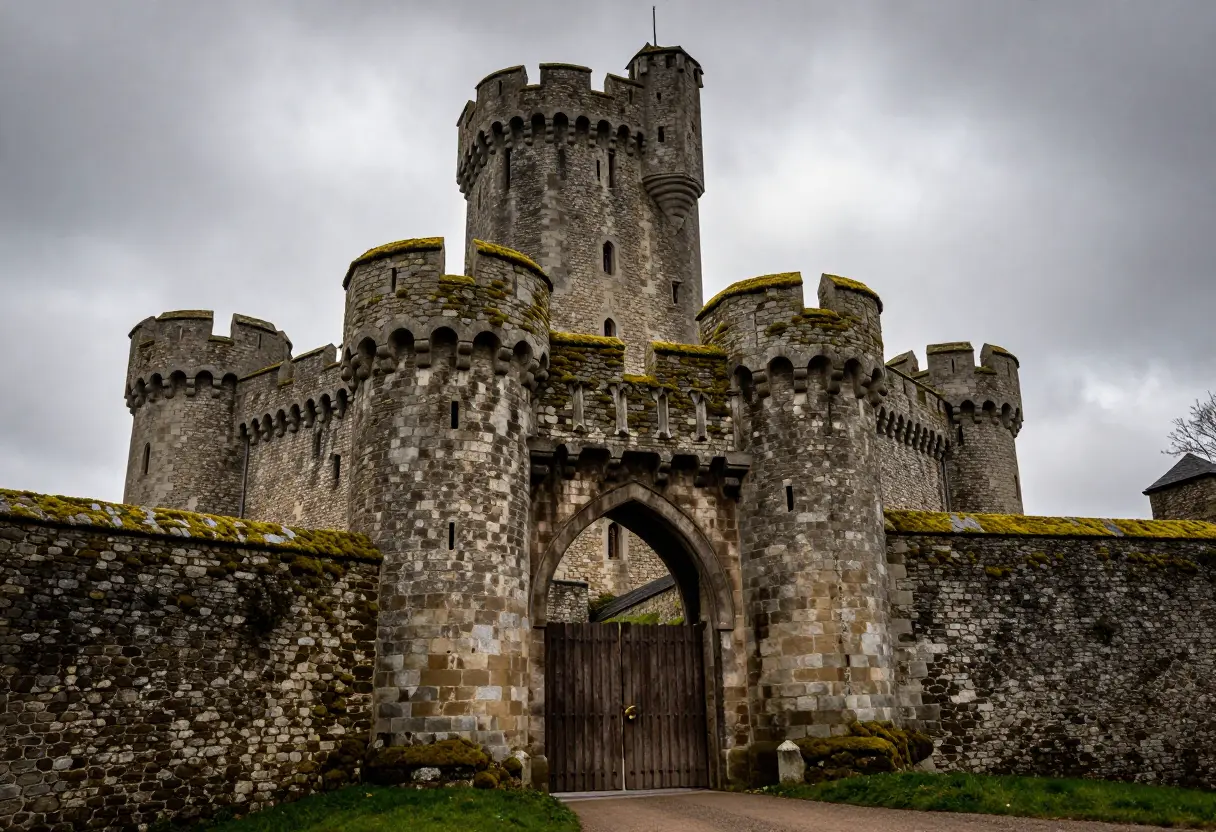
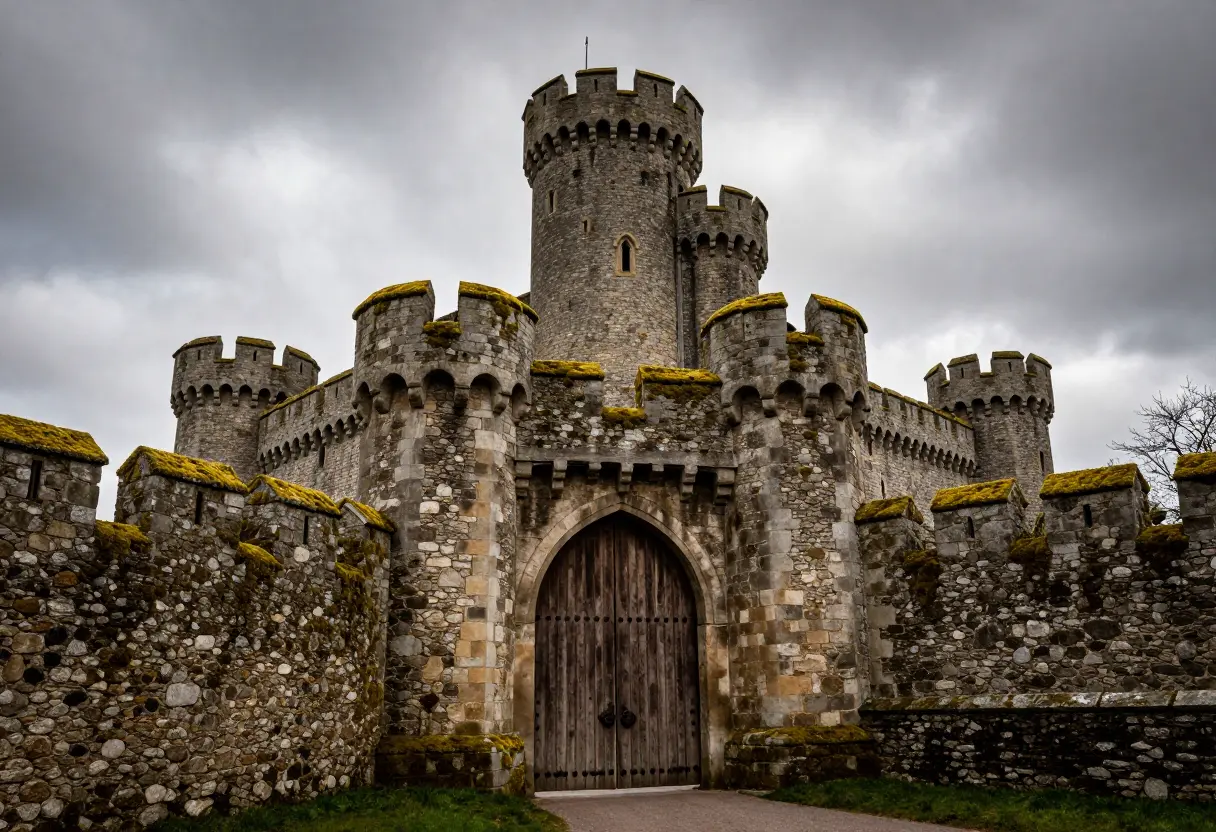
Englischer Prompt
Mit dem deutschen Prompt haben sich dagegen ein paar Fehler in die Texturen eingeschlichen, und Details wie das Moos gingen weitgehend verloren. Die Grundkomposition stimmt zwar noch, im Detail wirkt es aber deutlich unsauberer:
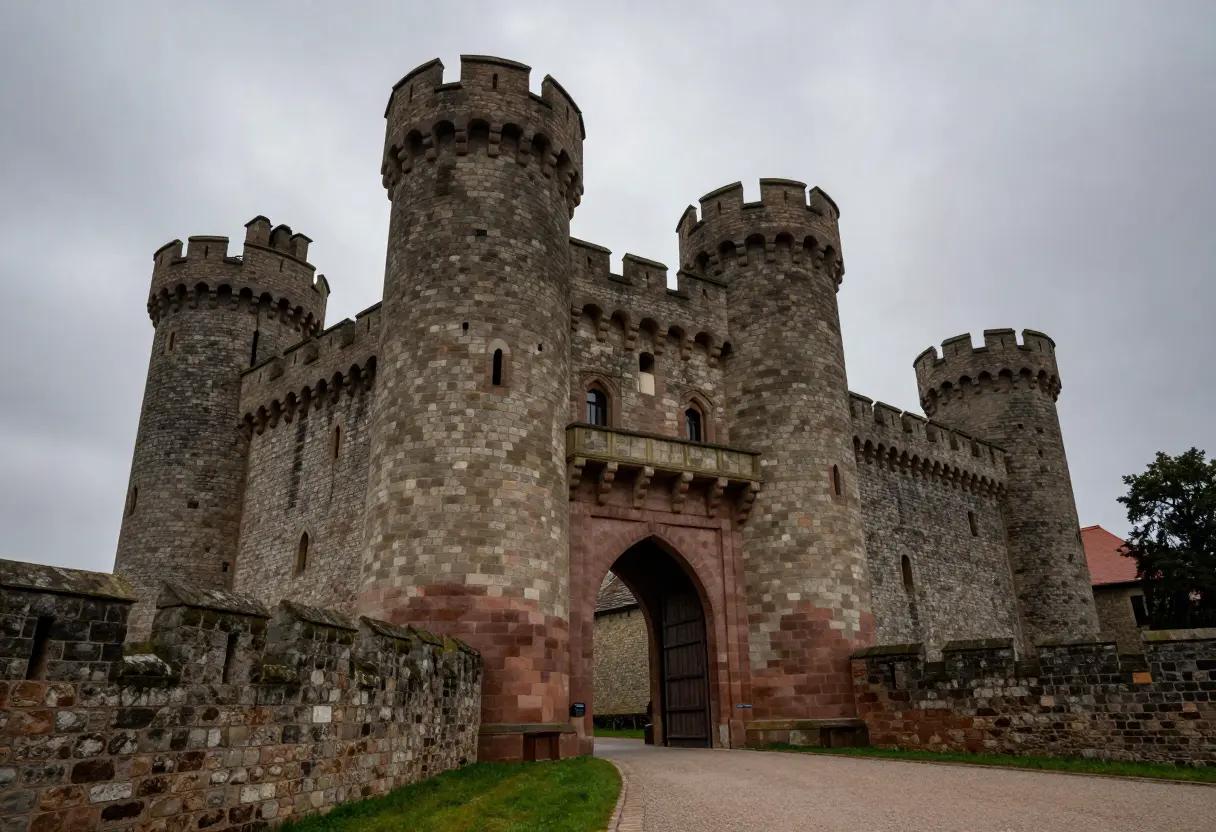
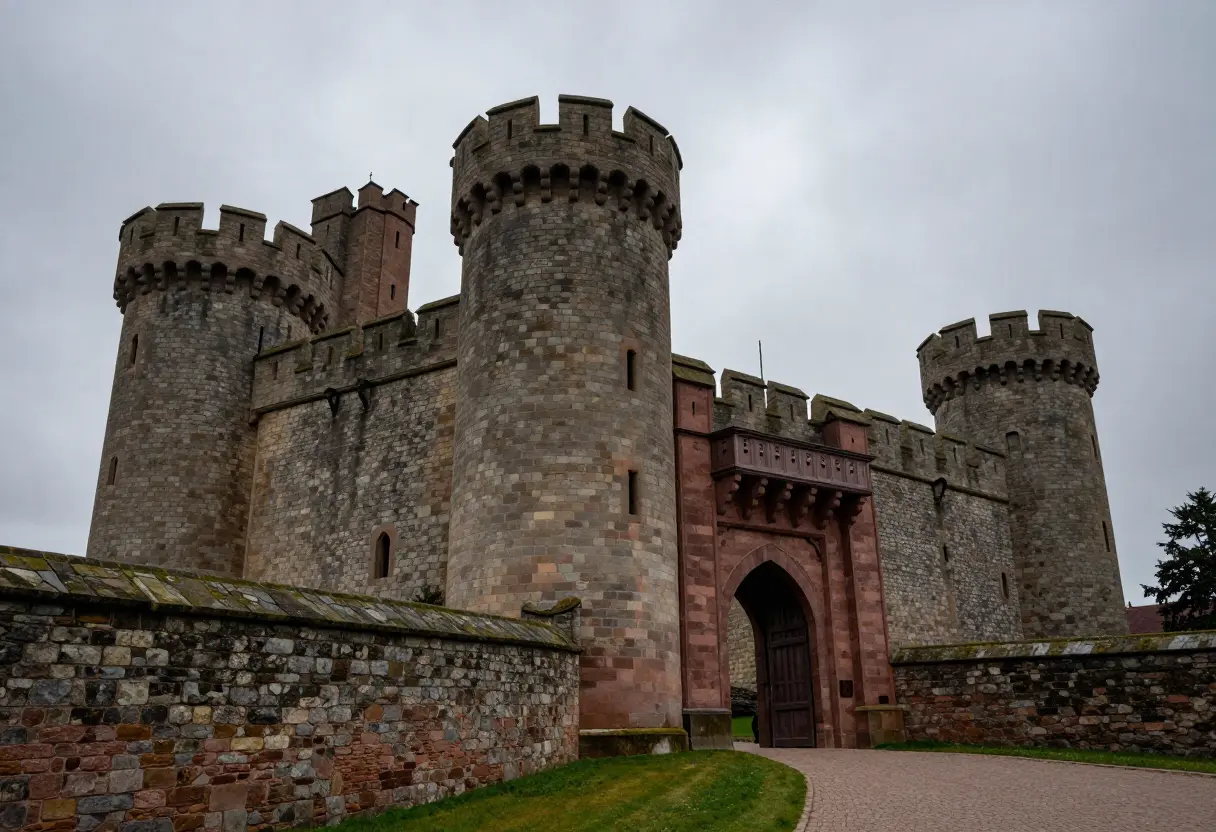
Deutscher Prompt
Das passt zu dem, was man über solche Modelle allgemein sagt: Trainiert werden sie ganz überwiegend auf englischsprachigen Bildbeschreibungen, und entsprechend am besten „versteht" der Text-Encoder eben Englisch. Wer verlässliche Ergebnisse will, tippt seinen Prompt also besser gleich auf Englisch ein.
Fazit
Z-Image Turbo ist für mich vor allem eins: schnell. Der Workflow ist im Kern derselbe wie bei Flux.1-Dev, aber durch die wenigen Steps und den schlankeren Aufbau bekommt man deutlich zügiger ein Ergebnis auf den Schirm. Für das schnelle Ausprobieren einer Bildidee ist das großartig - man würfelt in kurzer Zeit ein paar Varianten durch und schaut, was trägt.
Ich sehe die beiden Modelle deshalb gar nicht als Konkurrenten, sondern als zwei Werkzeuge für zwei Situationen: Z-Image Turbo, wenn es schnell gehen soll, und Flux, wenn ich mir für das eine, möglichst gute Bild mehr Zeit und mehr Steps gönnen will. Und das Schöne am Node-Ansatz von ComfyUI ist ja: Ich muss dafür nicht bei null anfangen, sondern tausche in meinem bestehenden Graphen im Grunde nur eine Handvoll Nodes aus.